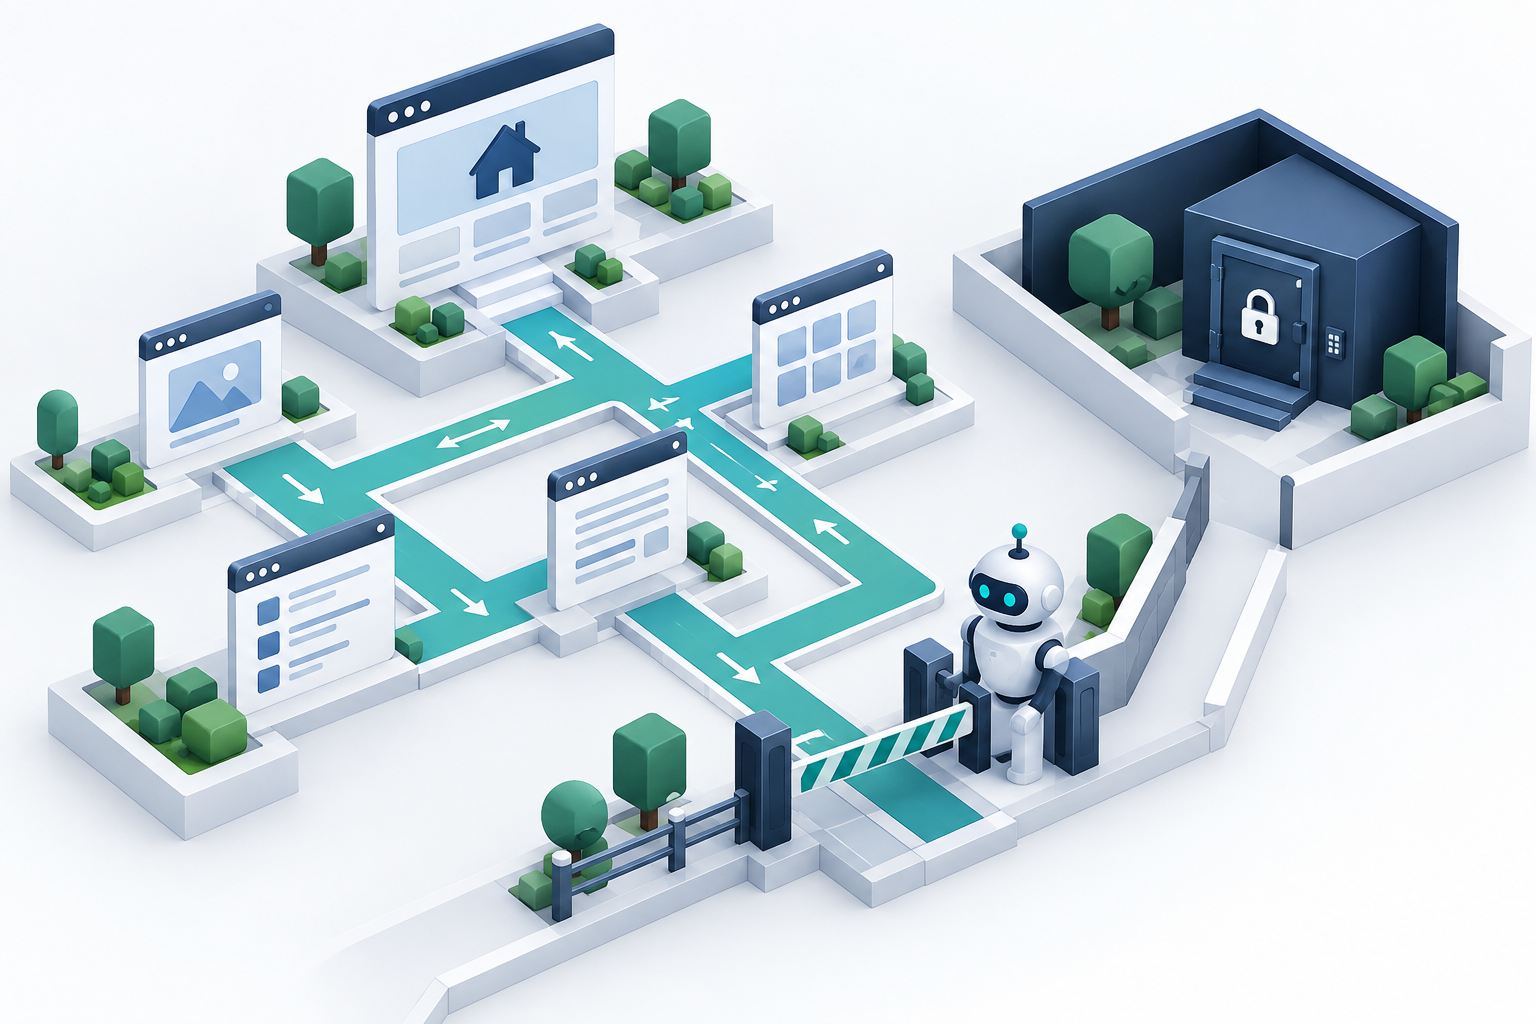
“不让搜索引擎看到”可能有三种完全不同的含义:减少无用抓取、不让公开页面出现在搜索结果、保护私密信息。先确定目标,再选 robots.txt、noindex 或真正的访问控制,能避免常见的规则冲突。
用页面用途决定处理方式
| 页面类型 | 期望结果 | 应先检查的机制 |
|---|---|---|
| 希望获得自然搜索访问的文章 | 公开访问并允许被发现、抓取和评估 | 正文可访问,索引指令无误,存在站内入口 |
| 公开但不希望出现在搜索结果的页面 | 用户可访问,搜索引擎读到排除索引指令 | 受该引擎支持的 noindex 实现 |
| 大量无价值的参数组合 | 控制重复抓取 | URL生成方式与抓取规则,另行处理已有索引 |
| 订单、后台、内部报告 | 未经授权不能读取 | 登录、权限校验和网络访问控制 |
Google 明确说明,robots.txt 不是可靠的“隐藏页面”机制。页面被禁止抓取后,其 URL 仍可能因外部链接而被发现。noindex 也不是密码保护:它不阻止普通访问者直接打开网址。
最容易出现的冲突
在 robots.txt 中禁止了某页抓取,同时又在该页放置 noindex,Googlebot 可能无法读取后者。因此不能把两者简单叠加为“双重保险”。若页面已有索引,需要结合当前状态安排处理,而不是反复开关整站抓取权限。
HTML 页面常见的 noindex 写法如下,位置是文档 head。这里只是说明语法,不应直接复制到希望收录的文章模板中。
<meta name="robots" content="noindex">非 HTML 文件也可能通过 HTTP 响应头表达索引指令,例如 X-Robots-Tag。排查时既要看页面代码,也要看响应头;WordPress 插件、主题和反向代理可能分别输出规则。不同搜索引擎的支持范围和处理节奏需要分别验证。
上线前准备四个样本
选择一篇公开文章、一张分类列表、一页需要排除索引的公开页面,以及一个未经登录不应访问的后台地址。为每个样本写出预期,再检查实际状态码、响应头、HTML 指令和匿名访问结果。测试环境中用于防止提前收录的规则,尤其容易在上线后遗留。
如果发现私密内容已经公开,应先修复访问边界,再处理搜索结果清理;不能以搜索结果暂时消失代替数据保护。公开附件的权限设计可参考对象存储公开与私密文件的验收方法。
保留能复查的证据
保存变更前后规则、样本 URL、验证时间及平台诊断结果。搜索结果变化存在处理延迟,宜根据同一 URL 的后续抓取与索引状态判断,不要只凭一次 site: 查询就断定规则无效。
参考资料
作者:lgd。资料核对:2026-10-08。本文采用 AI 辅助整理;示例用于说明方法,不代表本站实测数据。