WAF 上线后出现抓取失败,不能只凭“浏览器能打开”就排除防护规则。浏览器可能已经持有验证 Cookie,而搜索爬虫没有;反过来,日志里写着 Googlebot,也不能证明请求来自 Google。排查顺序应是:找到实际失败请求,确定拦截层,再验证来源和调整规则。
先收集一条可以对应的失败记录
从搜索平台的抓取诊断中记下完整 URL、测试时间及错误类型,再到边缘日志中寻找同一时段的请求。建议记录路径、状态码、请求标识、规则编号、处置动作和回源状态。不要把包含令牌的完整查询字符串直接放进公开工单。
| 观察到的结果 | 下一步核对 |
|---|---|
| 边缘返回403,源站无对应请求 | 查看边缘访问控制、机器人规则和挑战动作 |
| 边缘已回源,源站返回403 | 查看源站鉴权、路径限制和应用插件 |
| 状态码200,正文却是验证页面 | 检查实际响应内容,不以200判定抓取成功 |
| 只有图片或脚本失败 | 检查资源域名上的防盗链与防护策略 |
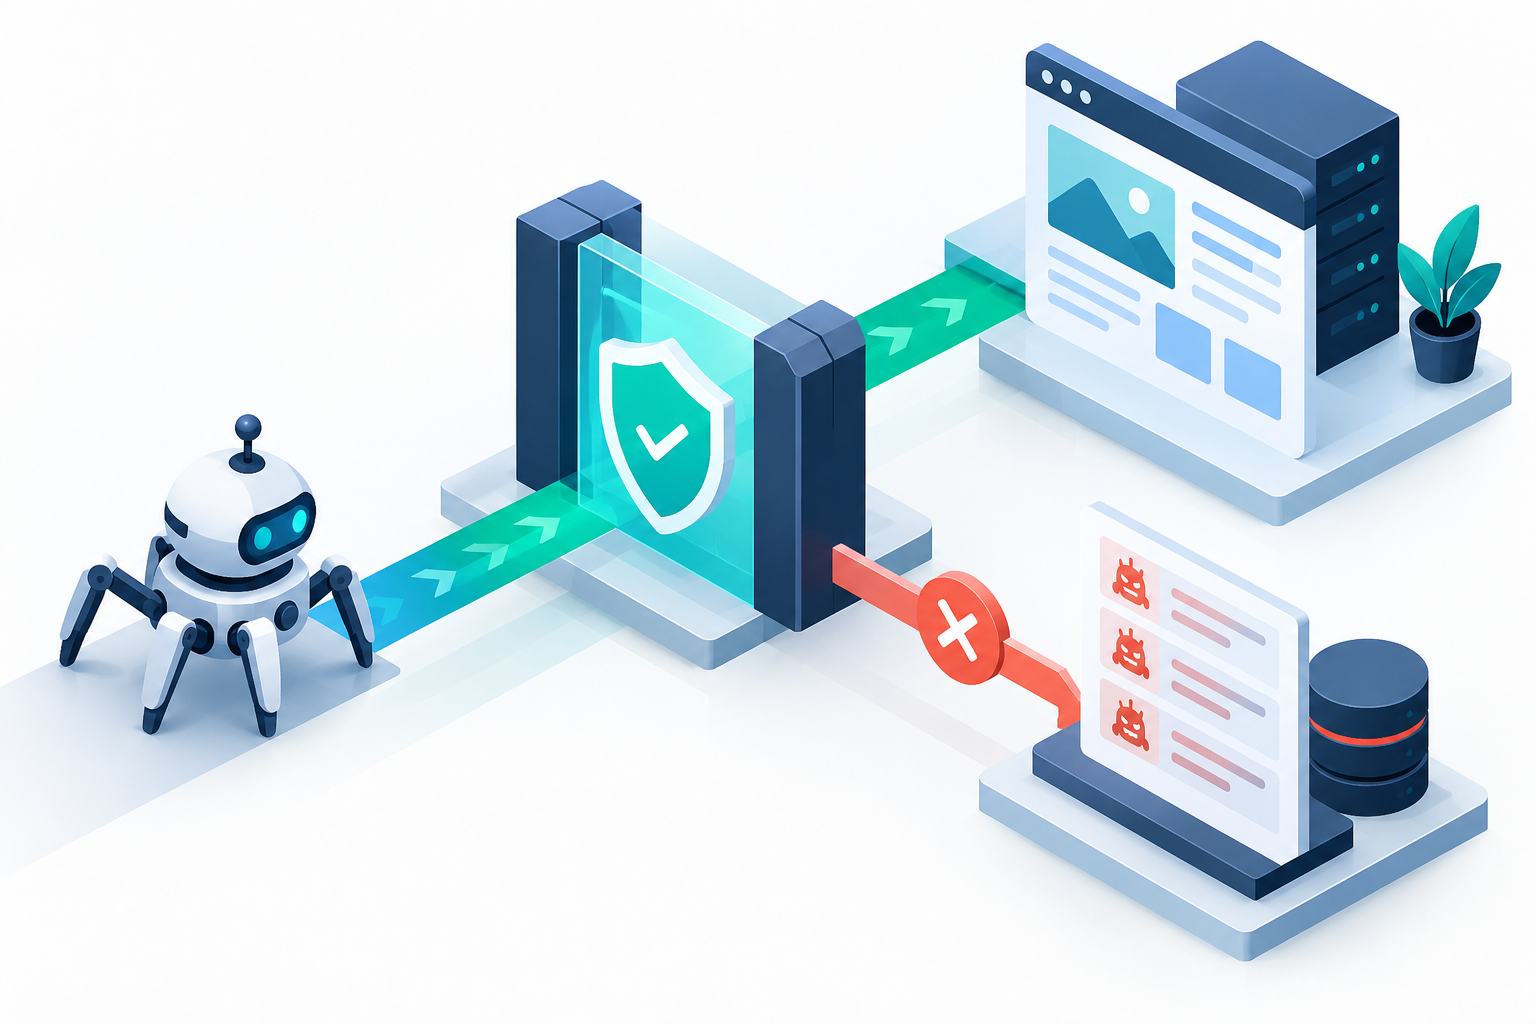
验证爬虫身份,不能只匹配 User-Agent
Google 官方提供反向 DNS 后再正向核对,以及使用公布的 IP 范围进行自动验证的方法。反向解析结果需按官方域名后缀规则校验,随后正向解析必须包含原始来源 IP;不能接受仅仅包含“google”字样的任意主机名。不同类型的 Google 抓取器使用的范围不同,应按实际用途选择。
对于 Baiduspider,应另外查阅百度平台当时提供的身份验证说明,不把 Google 的地址范围套用过去。经过代理时,还要确保日志中的真实来源字段来自可信代理链,相关配置可参考真实访客 IP 的核对流程。
用对照测试定位,而不是伪装成真实爬虫
下面命令只比较不同 User-Agent 的响应,不代表请求已经被验证为 Googlebot。请在自己的站点上低频测试;Windows 可使用 curl.exe。
curl -sS -D normal.headers -o normal.html "https://example.com/guide/"
curl -sS -A "Googlebot" -D ua-test.headers -o ua-test.html "https://example.com/guide/"
若两份响应不同,结合规则日志找出触发条件。不要因此新增“名称包含 Googlebot 就放行全部路径”的规则。公开文章的读取请求、登录接口和管理后台应保持不同的访问边界,也不应给爬虫提供与普通访客实质不同的正文。
什么情况下算修复完成
例外应限定到已验证来源、所需路径与请求方式,保留监控和撤销条件。再次运行平台抓取诊断,检查正文、图片和必要脚本都能读取,并回归普通访客及未经验证请求的行为。抓取恢复只解决访问问题,不保证立即收录或排名提升。
参考资料
作者:lgd。资料核对:2026-10-08。本文采用 AI 辅助整理;示例用于说明方法,不代表本站实测数据。